Yapay zekâ ekosisteminde neredeyse her hafta yeni bir model duyuruluyor: “En akıllısı”, “en yüksek akıl yürütme skoruna sahip olanı”, “matematik testlerinde rekor kıranı”… Şirketler kendi hazırladıkları teknik raporlarda seçilmiş kıyaslama (benchmark) testlerini öne sürerek zirvede olduklarını iddia ederken, son kullanıcı ve geliştiriciler için temel bir soru cevapsız kalıyor: Gerçek dünyada, gerçek insanların soruları karşısında gerçekten en iyi yapay zekâ hangisi?
Klasik akademik testlerin (MMLU, GSM8K, HumanEval gibi) modeller tarafından ezberlenmesi (data contamination) ve şirketlerin bu testlere özel optimizasyon yapması, puan tablolarını güvenilmez hale getirdi. İşte bu karmaşayı dağıtmak, yapay zekâ modellerini yapay laboratuvar koşullarından çıkarıp gerçek hayat senaryolarında kafa kafaya yarıştırmak amacıyla geliştirilen Arena AI (eski ve yaygın adıyla LMSYS Chatbot Arena), bugün küresel yapay zekâ dünyasının en güvenilir ve prestijli tarafsız hakemi konumunda bulunuyor.
1. Arena AI Nedir ve Nasıl Doğdu?
Arena AI, UC Berkeley bünyesindeki araştırmacıların öncülüğünde kurulan LMSYS Org (Large Model Systems Organization) konsorsiyumu tarafından geliştirilen kitle kaynaklı (crowdsourced) bir açık model değerlendirme platformudur. Platformun çalışma felsefesi son derece yalın ancak devrimseldir: Yapay zekâ modellerini önceden hazırlanmış, ezberlenebilir soru setleriyle değil; doğrudan küresel internet kullanıcılarının girdiği anlık, öngörülemez ve serbest istemlerle (prompts) sınamak. Satranç dünyasında yüzyıldır kullanılan Elo derecelendirme sistemi ile tıp araştırmalarının altın standardı olan çift-kör (double-blind) test metodolojisini bir araya getiren Arena AI, günümüzde OpenAI, Google DeepMind, Anthropic, Meta ve açık kaynak topluluklarının yeni modellerini gizlice veya açıkça test ettiği küresel bir arenadır.
Arena AI’ın logosu, stilize bir sütun simgesine dayanıyor; bu marka kimliği 28 Ocak 2026’da tanıtılmış oldu.
2. Sistemin Çalışma Mantığı: Çift-Kör A/B Testi ve Elo Puanlaması
Arena AI’ın arayüzü son derece sade görünür, ancak arka planında titiz bir istatistiksel mekanizma işler:
[Kullanıcı İstemi (Soru / Kod / Analiz / Yaratıcı Metin)]
                        │
                        ▼
    ┌───────────────────┴───────────────────┐
    ▼                                       ▼
[Model A (Anonim Yanıt)]               [Model B (Anonim Yanıt)]
    │                                       │
    └───────────────────┬───────────────────┘
                        ▼
[Kullanıcının Kör Oylaması: A Daha İyi / B Daha İyi / Berabere]
                        │
                        ▼
[Kimliklerin İfşası (Örn: Model A = GPT-4o, Model B = Claude 3.5 Sonnet)]
                        │
                        ▼
[Bradley-Terry Modeli & Elo Puan Güncellemesi]
A. Kör Dövüş (Blind Battle)
- İstem Girişi: Kullanıcı metin kutusuna herhangi bir soru yazar. Bu bir Python kodu hatası ayıklama, felsefi bir tartışma, karmaşık bir çeviri veya yaratıcı bir kurgu olabilir.
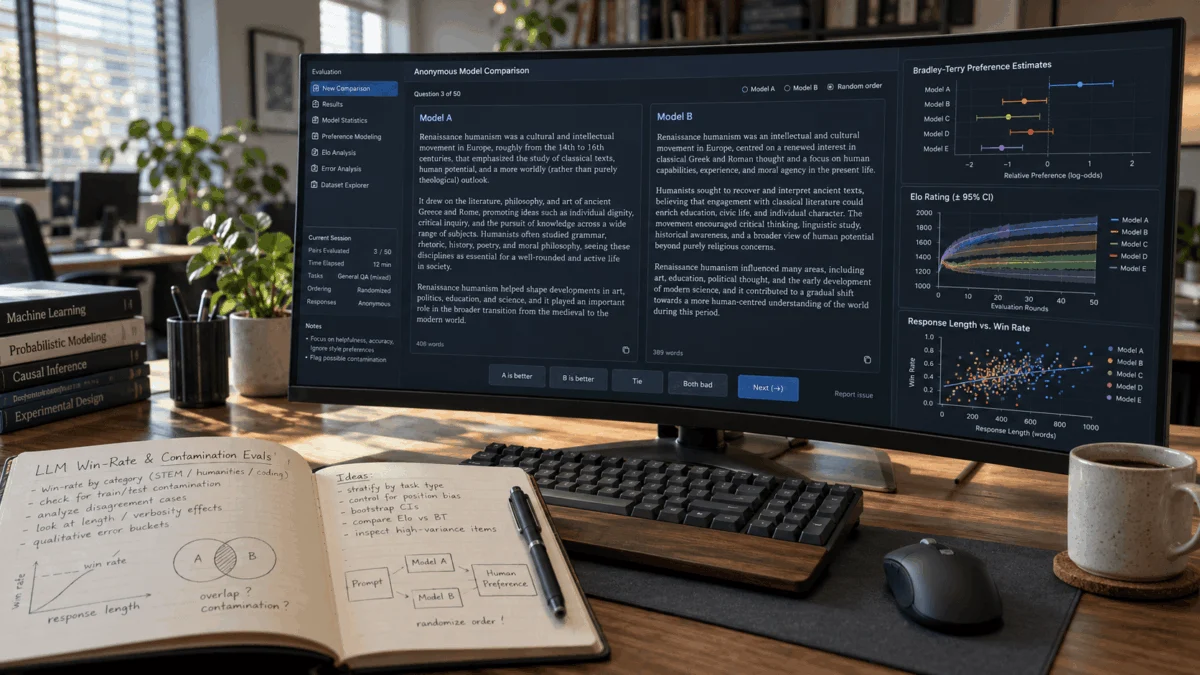
- Eşzamanlı Çıktı: Sistem, arka planda havuzdaki onlarca model arasından rastgele iki tanesini seçer ve ekranda yan yana iki sütun halinde (“Model A” ve “Model B”) eşzamanlı olarak yanıtları sunar.
- Gizli Kimlik: Yanıtlar üretilirken kullanıcı hangi modelin OpenAI’a, hangisinin Google’a veya açık kaynaklı bir Llama varyantına ait olduğunu göremez. Bu sayede marka algısı, pazarlama önyargısı veya kişisel sempati elenir.
- Oylama ve İfşa: Kullanıcı “Model A daha iyi”, “Model B daha iyi”, “İkisi de eşit” veya “İkisi de kötü” butonlarından birine tıklar. Oy verildiği anda sistem iki modelin gerçek isimlerini açıklar ve perde arkasını gösterir.
B. Satrançtan İlham Alan Elo ve Bradley-Terry İstatistiği
Her oylama, iki yapay zekâ modeli arasında oynanmış bir satranç maçı olarak kabul edilir.
- Eğer Elo puanı daha düşük olan açık kaynaklı küçük bir model (örneğin Mistral 7B), devasa bütçeli bir tescilli modeli (örneğin GPT-4 sınıfı bir rakibi) yenerse, kazanan model hanesine çok büyük bir Elo puanı eklenir; kaybeden ise ciddi puan kaybeder.
- Milyonlarca insan oylamasının ardından hesaplanan Bradley-Terry olasılık modeli, sistemdeki her yapay zekânın gerçek kabiliyet derecesini hata payı güven aralıklarıyla (confidence intervals) net bir liderlik tablosuna döker.
3. Temel Yetenekler ve Kategori Odaklı Karşılaştırmalar
Arena AI, yalnızca genel sohbet performansını değil, modellerin uzmanlaştığı alt disiplinleri de detaylı filtrelerle sınıflandırır:
- Kodlama Arenası (Coding Battle): Yazılım mühendislerinin girdiği karmaşık algoritmalar, hata ayıklama (debugging) ve sistem tasarımı soruları üzerinden modellerin teknik doğruluğu ölçülür.
- Zorlu Görevler (Hard Prompts): Modellerin en çok zorlandığı, çok adımlı mantık yürütme, tuzak sorular ve karmaşık analitik kurgulardan oluşan filtrelenmiş elit soru kümesi.
- Görsel ve Çok Modlu (Multimodal / Vision) Desteği: Kullanıcıların fotoğraf, diyagram ve grafik yükleyerek modellerin görsel anlama ve çıkarım kabiliyetlerini doğrudan kör testte kıyaslayabildiği kategori.
- Çok Dilli (Multilingual) Değerlendirme: İngilizce dışındaki dillerde modellerin yerel deyimlere, kültürel bağlamlara ve dilbilgisi kurallarına hâkimiyetini test eden küresel segment.
- Doğrudan Sohbet (Direct Chat / Playground): Kullanıcının istediği spesifik bir modeli (örneğin Gemini Flash, Claude Opus veya Llama) doğrudan seçerek test edebileceği, API anahtarı gerektirmeyen serbest deneme alanı.
4. Sektörel ve Bilimsel Önemi: Neden “Yapay Zekânın Altın Standardı”?
Arena AI’ın teknoloji dünyasında bu denli vazgeçilmez hale gelmesinin ardında üç kritik dinamik yatmaktadır:
- Ezberlemenin (Data Contamination) İmkânsızlığı: Geleneksel statik test soruları internette yayınlandığı için yapay zekâ şirketleri bu soruları modellerin eğitim verisine ekleyerek yapay skorlar elde edebiliyordu. Arena’da ise sorular anlık olarak dünyanın dört bir yanındaki yüz binlerce farklı insandan gelir; dolayısıyla ezberlenmesi teknik olarak mümkün değildir.
- Gizli Önizleme (Canary/Preview Models): Teknoloji devleri (OpenAI, Google, Anthropic vb.), piyasaya sürmeye hazırlandıkları gizli modelleri kod adlarıyla (örneğin “im-also-a-good-gpt”, “anonymous-chatbot”) önce Arena AI’a sürer. Topluluğun tepkilerini ve Elo skorunu görerek nihai lansman stratejilerini belirlerler.
- Mühendisler İçin Karar Destek Aracı: Bir şirket kendi iş akışlarına yapay zekâ entegre edeceği zaman; pazarlama broşürlerine değil, Arena liderlik tablosuna bakar. Maliyet/performans eğrisinde hangi açık kaynak modelin kapalı devlerle başa baş mücadele ettiğini doğrudan bu verilerle tespit eder.
Sonuç olarak;
Arena AI, yapay zekâ çağının en demokratik, şeffaf ve denetleyici ekosistemidir. Karmaşık matematiksel teorileri ve kurumsal pazarlama yanılsamalarını bir kenara bırakarak, zekânın gerçek değerini “insan deneyimi ve tercihi” ekseninde ölçer. İster hangi modeli kullanacağınıza karar vermek isteyen bir son kullanıcı olun, ister projeleriniz için en optimize modeli arayan bir mühendis; Arena AI, yapay zekâların bu amansız yarışında yönünüzü bulmanızı sağlayan en güvenilir pusuladır.
Yorumlar (0)